27 июня 2026, 15:22
DeepSeek выложил в open source DSpark — компонент, ускоряющий ответы ИИ почти вдвое
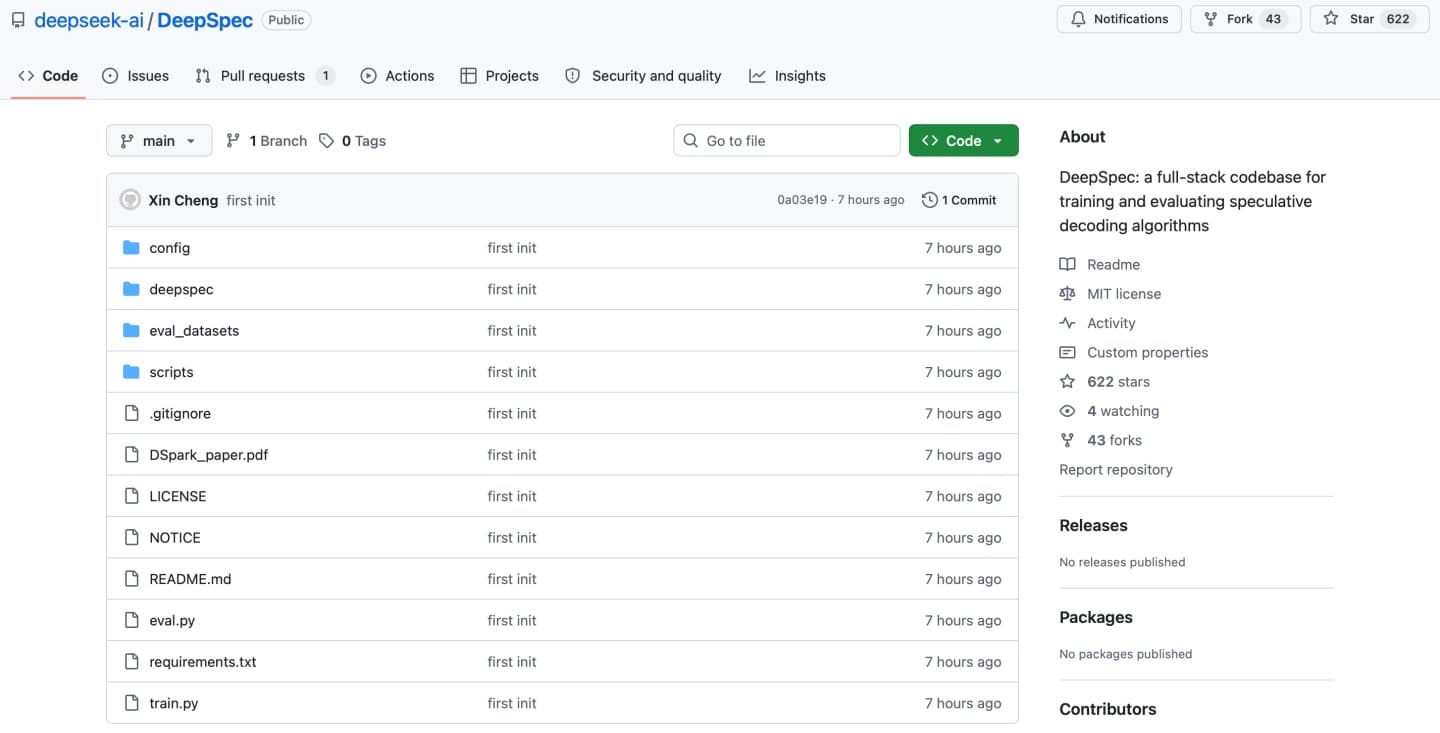
Организация DeepSeek совместно с Пекинским университетом выпустила DSpark — компонент, который ускоряет выдачу ответов нейросети, не меняя саму модель. На боевых серверах превью-версий DeepSeek-V4-Flash и V4-Pro скорость генерации для каждого пользователя выросла до +85%. Исходник и технический отчет организация опубликовала на GitHub.
Техника относится к классу спекулятивного декодирования и ускоряет ответы без потери качества — итоговый текст остается математически идентичным обычной генерации. Прирост измеряли по сравнению с прежнего рабочего варианта под названием MTP-1.
Под капотом — две идеи. Сама модель спекулятивного декодирования устроена так: легкая модель-черновик забегает вперед и быстро набрасывает сразу несколько токенов (слов или их частей), а большая схема проверяет весь блок за один проход — это дешевле, чем генерировать те же токены по одному. Совпавший отрезок с начала блока принимается целиком, и пользователь получает некоторое количество слов за время одного шага. Загвоздка — в качестве черновика: если набрасывать токены блока разом и независимо друг от друга, они плохо стыкуются, и схема легко склеит начало одной фразы с концом иной. Чем дальше от начала блока, тем больше такого брака и тем больше токенов в итоге отвергается. DeepSeek оставил оперативный параллельный черновик, но внедрил к нему крошечный последовательный компонент, который перед каждым следующим токеном оглядывается на уже выбранные. Склейка перестает разваливаться, а скорость черновика почти не страдает.
Вторая идея — не проверять лишнего. Тест блока не бесплатна: под высокой нагрузкой каждый лишний токен занимает в очереди место, которое могло бы достаться другому пользователю, а токены в хвосте блока все равно чаще отвергаются. Поэтому DSpark заранее оценивает для каждого токена шанс пройти проверку, а отдельный планировщик в реальном времени смотрит на загрузку видеокарт: пока ресурсы свободны, он расширяет проверку с прежних двух токенов до пяти-шести, а под пиковой нагрузкой обрезает блок до самых надежных. Так ускорение не оборачивается перегрузкой серверов в час пик.
Одновременно DeepSeek открыл DeepSpec — цельный набор инструментов для обучения таких моделей-черновиков. Внутри сразу три алгоритма, включая DSpark, а равным образом сопровождение чужих моделей — Qwen3 от Alibaba и Gemma от Google. То есть ускорять этим методом можно не только продукты самой DeepSeek, но и сторонние нейросети.
P.S. Поддержать меня можно подпиской на канал "сбежавшая нейросеть", где я рассказываю про ИИ с творческой стороны.
Читают сейчас
6 часов назад
Вебинар «Как строить защиту облачной инфраструктуры: от логов до мониторинга»
При переходе в облачный сервис многие боятся потерять контроль над безопасностью: кажется, что данные окажутся «где‑то там», а угрозы будет не отследить. 6 октября приглашаем вас на вебинар, где мы ра
7 часов назад
Исследователи изучили ещё одну причину коррозии, потенциально способную влиять на деградацию металлов
Если оставить металл под дождём в достаточной степени надолго, даже с защитным покрытием, коррозия в конце концов сделает своё дело. Изначально учёные выдвинули гипотезу, что причиной столь сильной ко
8 часов назад
В JavaDoc предлагают добавить заметки, которые сложно пропустить
В JavaDoc предлагают добавить тег @note. Он позволит выделять важные примечания прямо в документации api. Ознакомиться далее
9 часов назад
GlowByte приняла участие в конференции Smart Data – 2026 в Китае
GlowByte приняла участие в 8-й международной конференции FanRuan Smart Data Conference – 2026, которая прошла 10–12 сентября в Ухане, в отеле InterContinental Wuhan. Лозунг конференции в этом году – «
10 часов назад
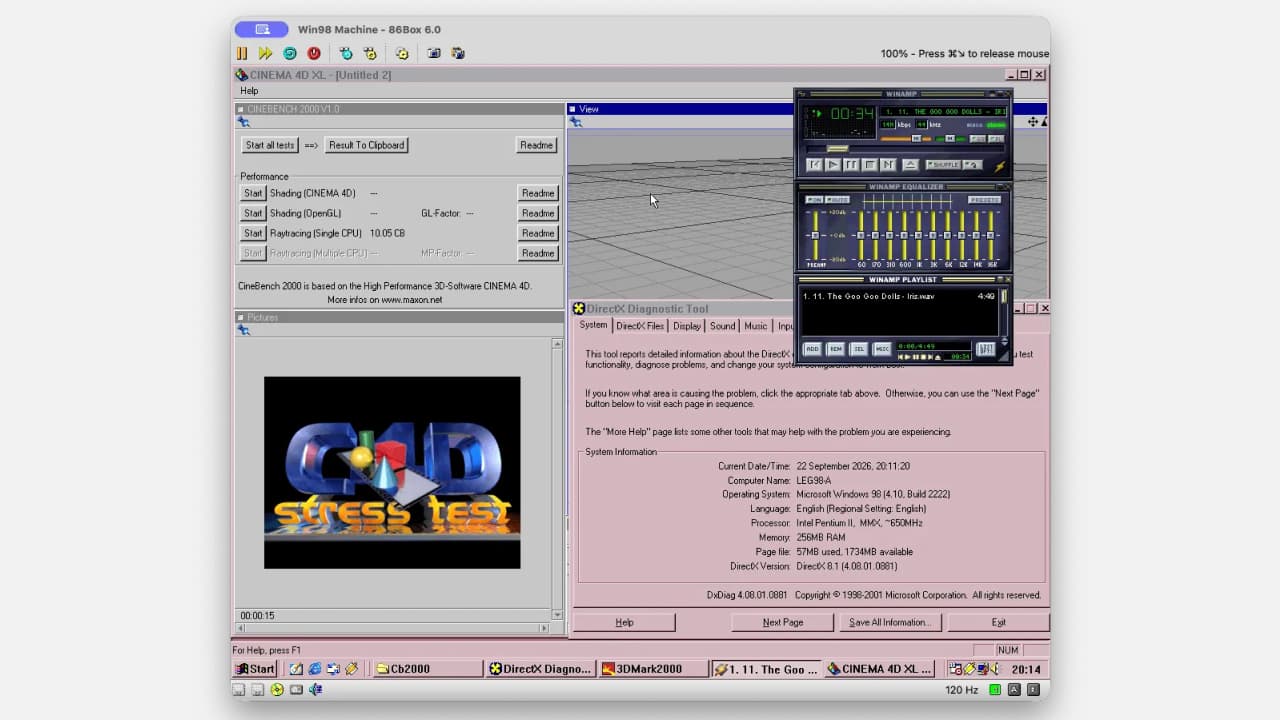
Mac mini с M6 стабильно эмулирует Pentium II на 600 МГц; итог на 20% выше, чем у Mac mini с M4
Разработчик протестировал свежий Mac mini с M6 в эмуляторе ретрокомпьютеров 86Box. Платформа смогла стабильно эмулировать Pentium II Deschutes с частотой 600 МГц под Windows 98 SE со 100% скоростью эм