1 час назад
Fine Day: на конференции GlowByte эксперты обсудили, как готовить информация для ИИ

23 октября в Москве GlowByte провела пятую юбилейную офлайн‑конференцию Fine Day. Тема мероприятия — «Из Self‑Service (аналитики самообслуживания) в AI‑Native (аналитику, изначально построенную на ИИ): новая архитектура корпоративной аналитики». Конференцию посетили порядка 250 человек: руководители аналитических подразделений крупных компаний, специалисты по данным и бизнес‑аналитике. Участники обсудили, какие условия нужно выполнить до запуска ИИ‑агентов, кто отвечает за подготовку данных и как проверять выводы ИИ, прежде чем представлять их руководству.
В демонстрационных зонах эксперты GlowByte и FanRuan показали новые возможности FineBI 7.0, ИИ‑агентов Dora (платформы дата‑агентов FanRuan), а также миграцию BI‑отчетов на FineBI с помощью ИИ‑инструмента Morphism AI.
Доверие к ответам ИИ: взгляд FanRuan
Международный директор по продукту и зарубежной стратегии FanRuan Лэнс Ли выступил с докладом «От инсайта к действию: построение доверенного корпоративного ИИ». Он отметил, что ответы ИИ дешевеют, а дефицитом становится возможность их проверить: в 40 тестовых запусках FanRuan 10 не прошли сверку с исходными данными целиком, а четыре инструмента на один и тот же вопрос о прибыли выдали четыре разных числа, от 31,8 до 34,0 млн юаней. Поэтому, по словам спикера, нужен ИИ‑агент, который открывает ход анализа: какие информация использованы, как они отфильтрованы и связаны, какие показатели рассчитаны. Такой решение FanRuan закладывает в Dora и в следующую версию FineBI, релиз которой запланирован на 2027 год.
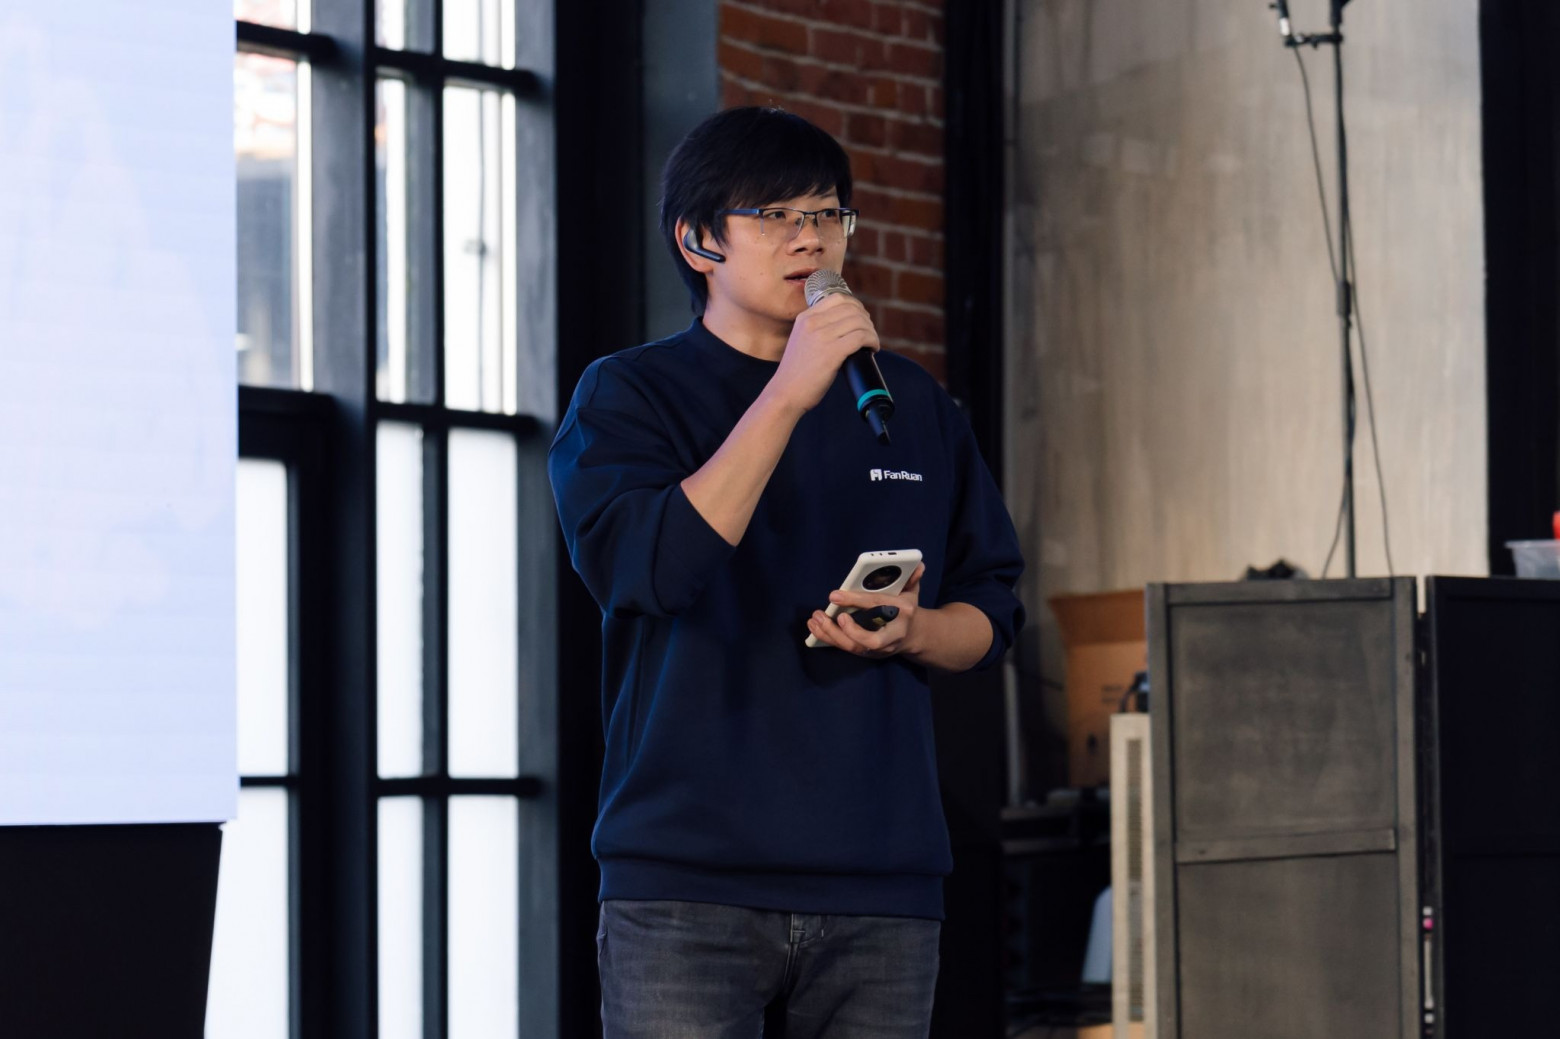
«Ответы дешевеют, а проверенные доказательства становятся дефицитом. Узкое место при принятии решений смещается от получения ответа к его проверке. Надежный результат дает агент, который сохраняет глубину анализа и оставляет каждый шаг — фильтрацию, связи, расчеты — доступным для проверки и правки», — отметил Лэнс Ли, международный директор по продукту и зарубежной стратегии, FanRuan.
Главная дискуссия: что нужно данным и командам, чтобы ИИ заработал
В круглом столе «AI‑Ready: что нужно данным и командам, чтобы ИИ заработал» приняли участие руководители подразделений бизнес‑аналитики из компаний ПИК, «Дикси» и «АвтоВАЗ». Модератором беседы выступил Александр Ларин, эксперт BI‑направления, руководитель центра поддержки и обучения GlowByte.
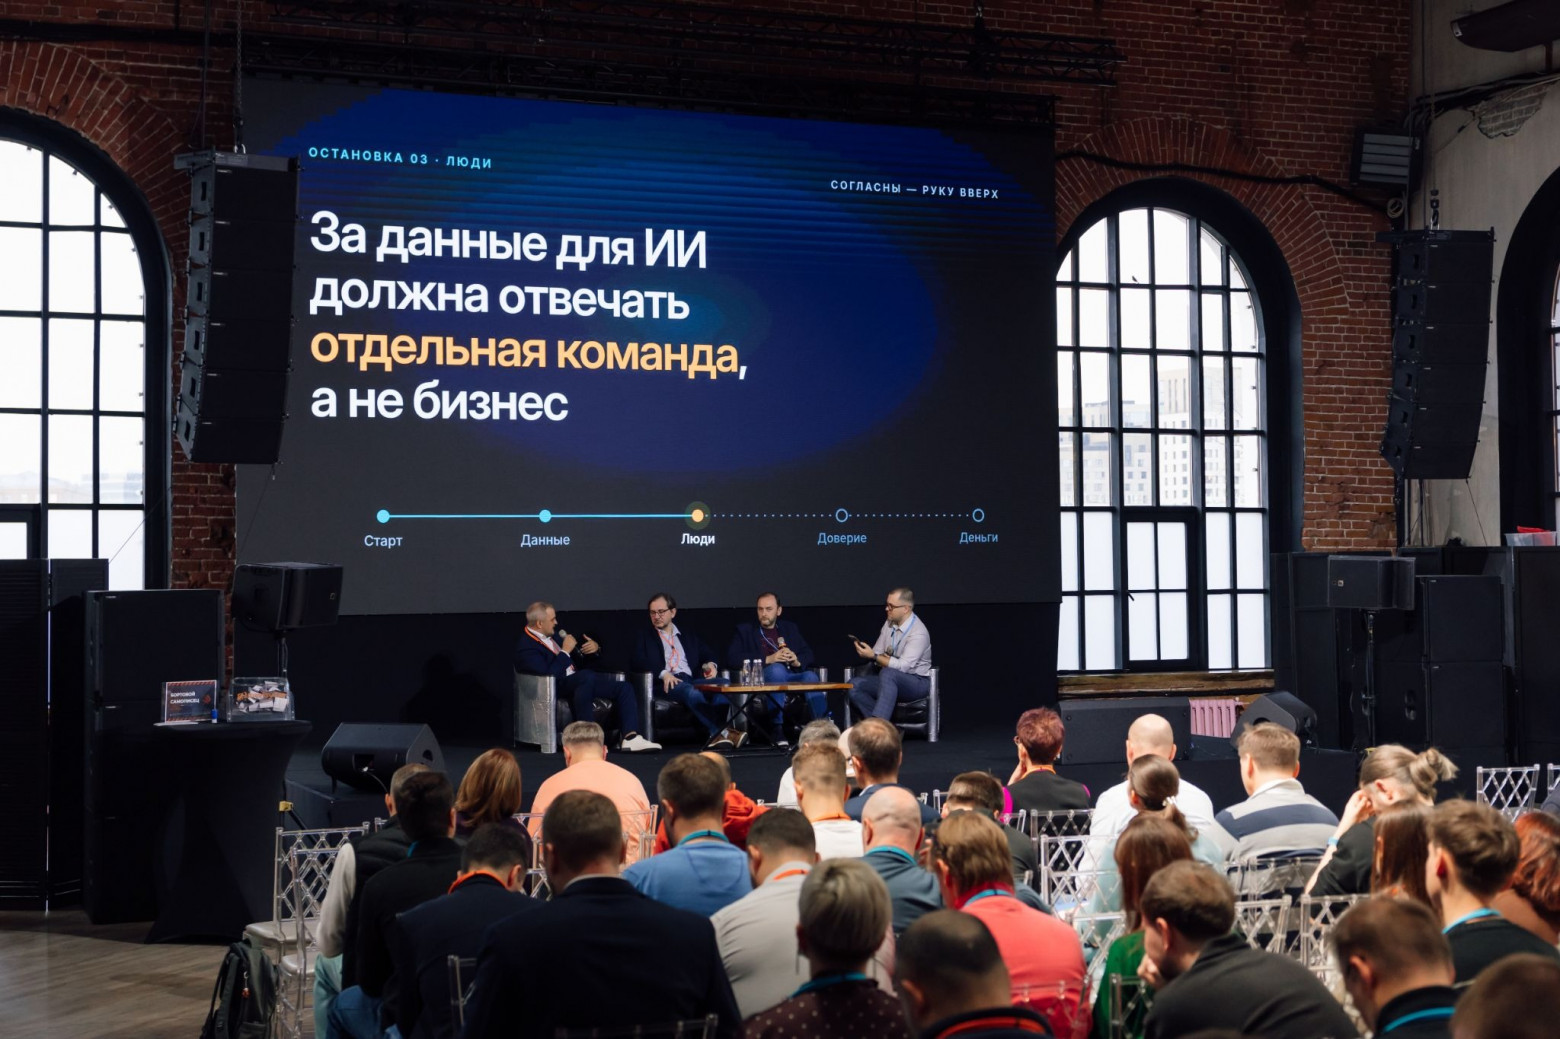
Разговор строился как путь одного ИИ‑проекта с пятью остановками: старт, данные, люди, доверие и деньги. Отправной точкой стал вопрос директора: «Почему в сентябре упала маржа в Центральном регионе?» Агент ответит за секунду, но можно ли ему верить?
Спикеры и зал разбирали спорные тезисы: начальный скрипт для ИИ‑агента должен быть скучным; главная проблема ИИ в аналитике — качество данных; за данные для ИИ должна отвечать отдельная команда, а не бизнес; ИИ в аналитике — не экономия, а новые расходы.
Итогом маршрута стали пять слов «на понедельник», по одному на каждую остановку: скрипт, смыслы, хозяин, проверка, отдача — выбран ли скрипт, понятны ли смыслы показателей, есть ли хозяин у данных, проверяются ли результаты и видна ли отдача.
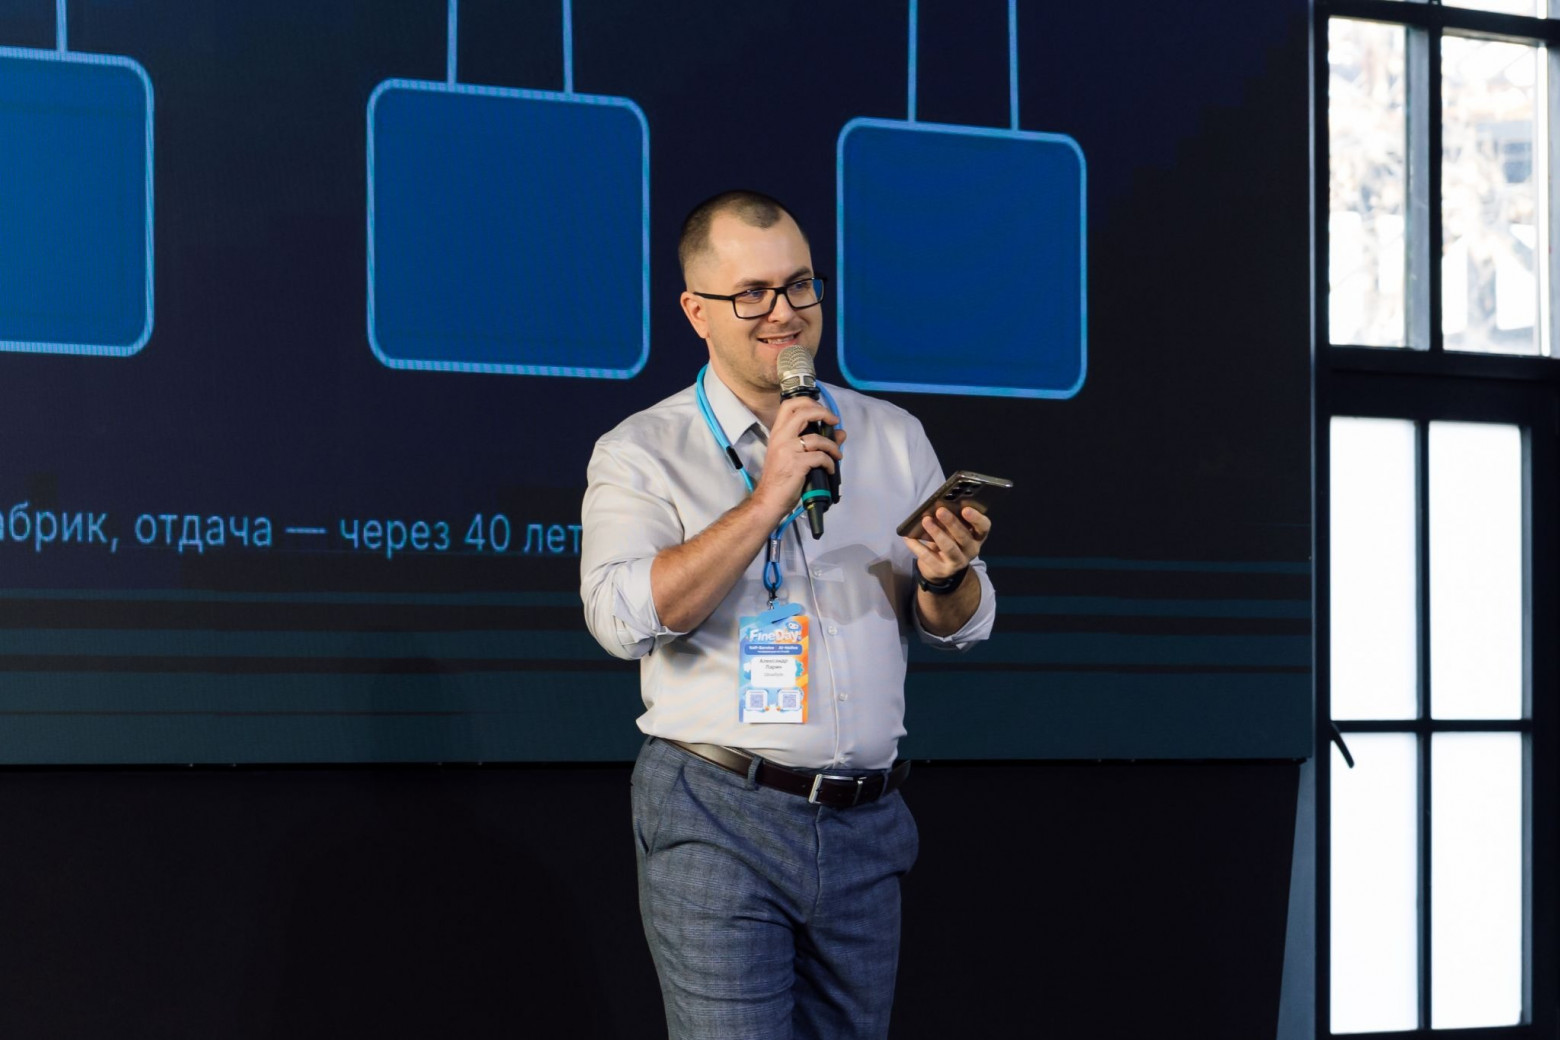
Модератор дискуссии Александр Ларин обратил внимание на то, как меняется роль ИТ: пользователи все реже ждут отчет по заявке и собирают его сами с помощью ИИ, а значит, подразделениям ИТ предстоит строить среду, в которой бизнес работает самостоятельно.
«ИИ становится новым электричеством. Мы же не задумываемся, как устроена электростанция, когда включаем свет. Так и с ответом нейросети: почти никто уже не проверяет, откуда взялась цифра. Ждать, пока ИТ сделает отчет по заявке, тоже больше никто не готов: быстрее собрать его самому с помощью ИИ за вечер. Следовательно ИТ больше не пишет каждый отчет за бизнес, а строит для него розетки и проводку: инфраструктуру, инструменты и проверенные информация, к которым пользователь подключается сам», — подытожил Александр Ларин, руководитель центра поддержки и обучения, GlowByte.
Как перенести отчеты из Qlik и Power BI в FineBI с помощью ИИ
Технический директор GlowByte Дмитрий Куроедов и консультант GlowByte Андрей Пашков представили отчёт «Morphism AI: автоматизированный перенос BI‑отчетности с Qlik и Power BI на FineBI». Morphism AI — решение GlowByte, в котором воплощен более чем десятилетний опыт проектов внедрения бизнес‑аналитики и экспертиза по платформе FineBI (FanRuan).
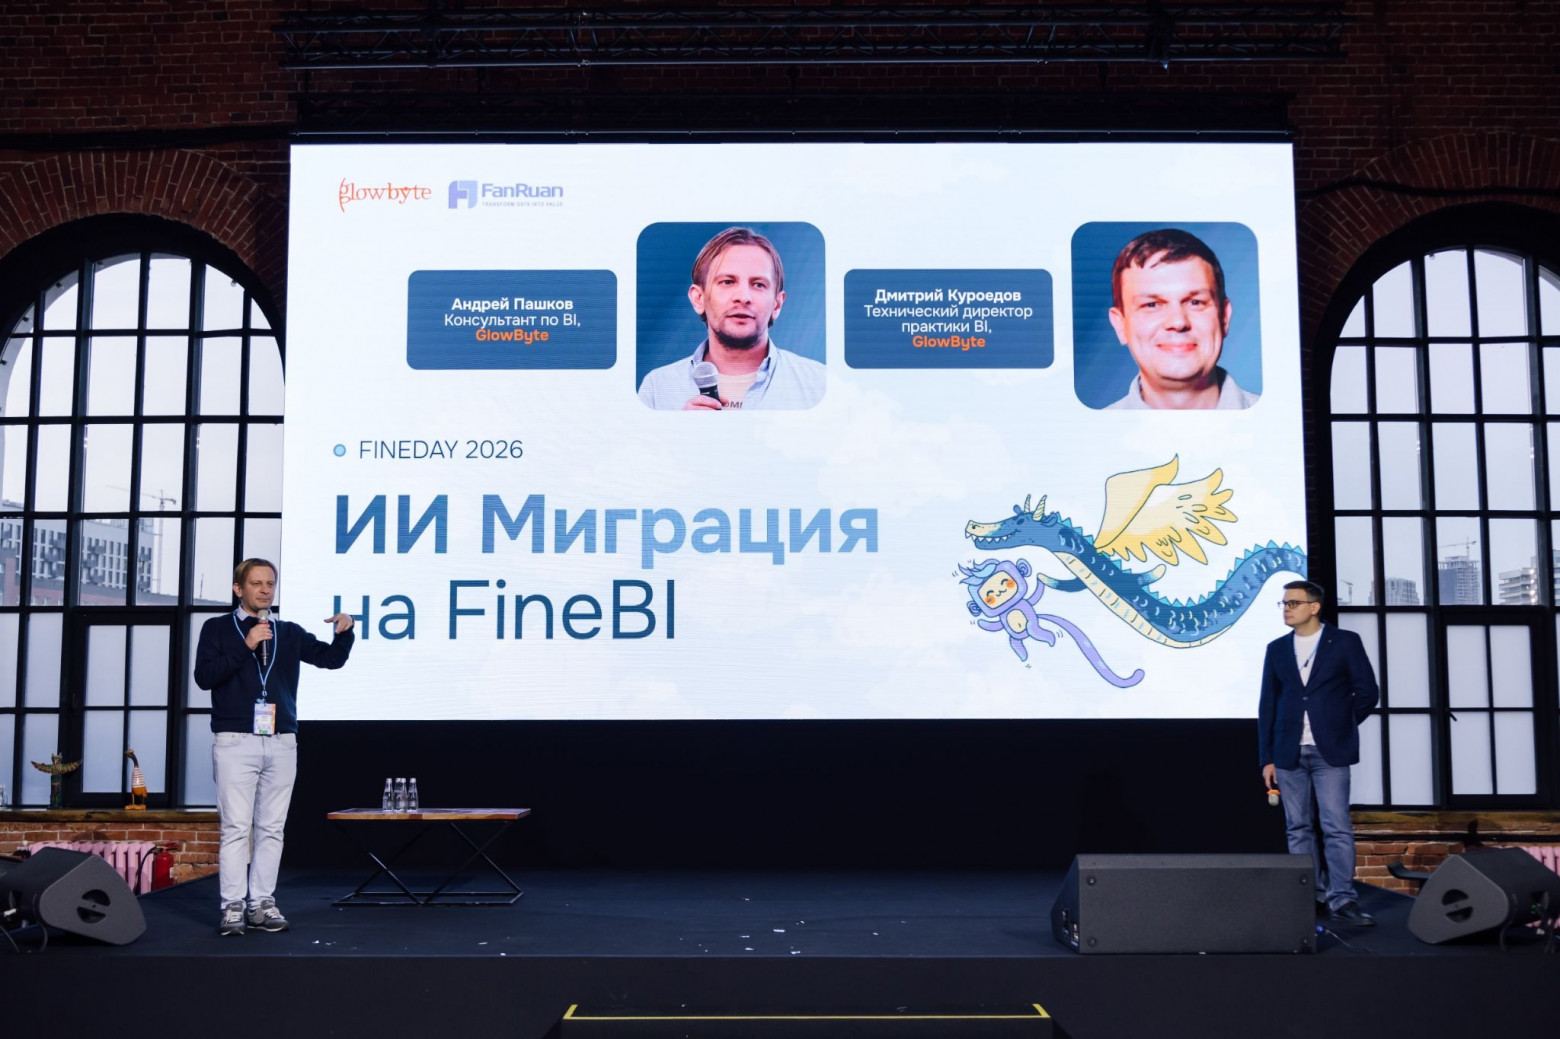
Для переноса данные компании не нужны: ИИ‑модель видит только описание и структуру отчетов, а решения принимает специалист.
Перенос идет в четыре шага:
Отчеты QlikView, Qlik Sense и Power BI приводятся к единой спецификации.
Логика загрузки данных переносится в витрины на открытом стандарте dbt (поддерживаются PostgreSQL, Trino, StarRocks и ClickHouse).
Визуализации и показатели переносятся в дашборды FineBI.
Комплект поставки разворачивается на тестовом стенде и проходит повторную сверку.
На каждом этапе результат сверяют с оригиналом: исходная платформа и новые витрины считают показатели на одних и тех же синтетических данных, ИИ‑модель анализирует расхождения и предлагает исправления.
Спикеры привели результаты:
загрузка данных (ETL): более 90% скриптов переносится автоматически;
визуализации: более 85% визуализаций Power BI переносится автоматически;
каталог переноса: для каждой из 469 функций DAX определено, переносится ли она точно, с заменой или требует доработки.
Morphism AI используется как инструмент проектной команды для быстрых пилотов и массовой миграции сотен и тысяч отчетов. Новая исходная платформа или целевая платформа подключается около за месяц. В следующей версии планируется перенос на уровень центра данных FineBI, в том числе корпоративные семантические слои.
«Ручной перенос сотен отчетов — это месяцы работы и сверка каждой цифры. Мы воплотили опыт проектов внедрения BI в решение, которое переносит отчеты автоматически и проверяет итог по значениям. ИИ видит только структуру отчетов, решения принимает специалист», — сказал Дмитрий Куроедов, технический директор, GlowByte.
Мосбиржа: что отдать бизнес‑аналитике, а что — языковым моделям
Начальник управления развития и сопровождения аналитических систем Московской биржи Александр Нугаев выступил с докладом «Классы задач дата‑аналитики: что закрывает BI‑система, а что — LLM‑контур и почему HTML не убьет BI». Он разделил задачи по двум осям, цене ошибки и повторяемости, и выделил четыре класса: регламентная отчетность (FineBI над сертифицированными витринами), быстрые ответы по выверенным метрикам (GenBI — анализ на основе генеративного ИИ), нестандартные регулярные дашборды и разовая продуктовая аналитика в песочнице с большой языковой моделью (LLM). Вайб‑кодинг дашбордов (разработка дашбордов с помощью ИИ, который пишет код) спикер назвал не отдельным классом, а способом производства.
По оценке спикера, основную часть работы над дашбордом составляет фундамент: анализ, архитектура, интеграция, ролевая схема доступа и управление данными. Они занимают приблизительно 90% усилий, а ИИ ускоряет только написание кода визуализации, то есть остальные 10%. Регламентную отчетность, полагает Александр Нугаев, нельзя отдать языковой модели и по существу: дашборд — зафиксированный вычислительный контракт, который дает то же число завтра и через год, а модель недетерминирована по устройству.
Вторая причина — стоимость. Регламентный дашборд считается один раз, а каждый ответ модели — отдельное применение модели (инференс). По расчету спикера, 200 пользователей, которые открывают панель по пять раз в день, дают приблизительно 20 000 обращений в месяц и порядка 0,6 млрд токенов. Следовательно все, что спрашивают одинаково чаще раза в неделю, должно стать регламентным дашбордом, а повторяющиеся вопросы к GenBI — заявкой на новую метрику в системе бизнес‑аналитики.
Для безопасной работы контура GenBI Александр Нугаев назвал пять условий: единый семантический слой, наследование прав доступа, аудит по схеме «кто → что → зачем», маршрутизатор на входе, который сначала ищет готовый отчет, и телеметрия повторяющихся вопросов.
«LLM не отменяет BI — она его потребляет. Качественный семантический слой превращает LLM из генератора текста в аналитика, доступного каждому сотруднику, без погружения в BI‑интерфейсы. Нет метаслоя — нечего и спрашивать», — подчеркнул Александр Нугаев, начальник управления развития и сопровождения аналитических систем, Мосбиржа.
ОТП Банк: CI/CD для наборов данных как основа для ИИ
Петр Гордиенко (руководитель BI‑команды) и Евгений Иванов (DevOps и администратор BI) из ОТП Банка рассказали о подготовке данных для ИИ через CI/CD (непрерывную интеграцию и поставку) на FineBI. Раньше аналитики напрямую работали с производственными базами данных и правили любые наборы данных (датасеты). Из‑за этого росла нагрузка на базы, появлялось теневое память, а отчеты ломались из‑за чужих правок.
Теперь разработка идет только на тестовом контуре FineBI. Набор данных попадает в производственную среду (прод) через проверку кода (ревью) в Bitbucket: для каждого набора создаются отдельная ветка и заявка на проверку, а после одобрения он автоматически выкладывается в прод. Дополнительно банк разработал SQL Optimizer — помощника на основе ИИ для проверки SQL‑запросов. Он работает на локальной модели Qwen 27B, следовательно информация не уходят наружу. Качество результата обеспечивает набор алгоритмических правил: при четырех вариантах запроса с проверкой правильными оказываются 100 процентов результатов, при одном варианте без проверки — 20%. Карточки отчетов и происхождение данных (Data Lineage) ведутся в Data Ocean.
В результате нагрузка на производственные базы от FineBI снизилась приблизительно на 30%, SQL проверяется до выхода в прод, на ревью уходит приблизительно одного рабочего дня, а проверенные наборы данных накапливаются как семантический слой. По словам спикеров, именно он наряду с карточками отчетов и сведениями о происхождении данных служит условием для работы языковых моделей с данными. Второй шаг — пилот Dora для подготовки отчетов, проверки ответов и генерации дашбордов.
«Чтобы ИИ работал с данными, ему нужен проверенный семантический слой и контекст: откуда взялись цифры и кто за них отвечает. Мы строим это через CI/CD для наборов данных: ничего не попадает в прод без ревью», — отметил Петр Гордиенко, руководитель BI‑команды, ОТП Банк.
Как обучать команды работе с ИИ
Основатель проекта DataYoga Андрей Демидов выступил с докладом «ИИ уже в компании. Кто учит команду держать штурвал?». Он отметил, что во многих компаниях работники уже используют ИИ, но с разной глубиной, ответственностью и без общих правил проверки результата. Главный риск — отсутствие общей практики, а не нехватка технологий.
Спикер предложил рассматривать грамотность анализ как сочетание трех слоев: работы с данными, работы с ИИ и ответственного принятия решений.
Он также анонсировал бесплатный пятидневный онлайн‑марафон «ИИ без страха», который инициатива DataYoga проведет совместно с GlowByte: пять живых эфиров, разбор реальных рабочих ситуаций, практические задания, взаимная проверка работ и набор модулей материалов.
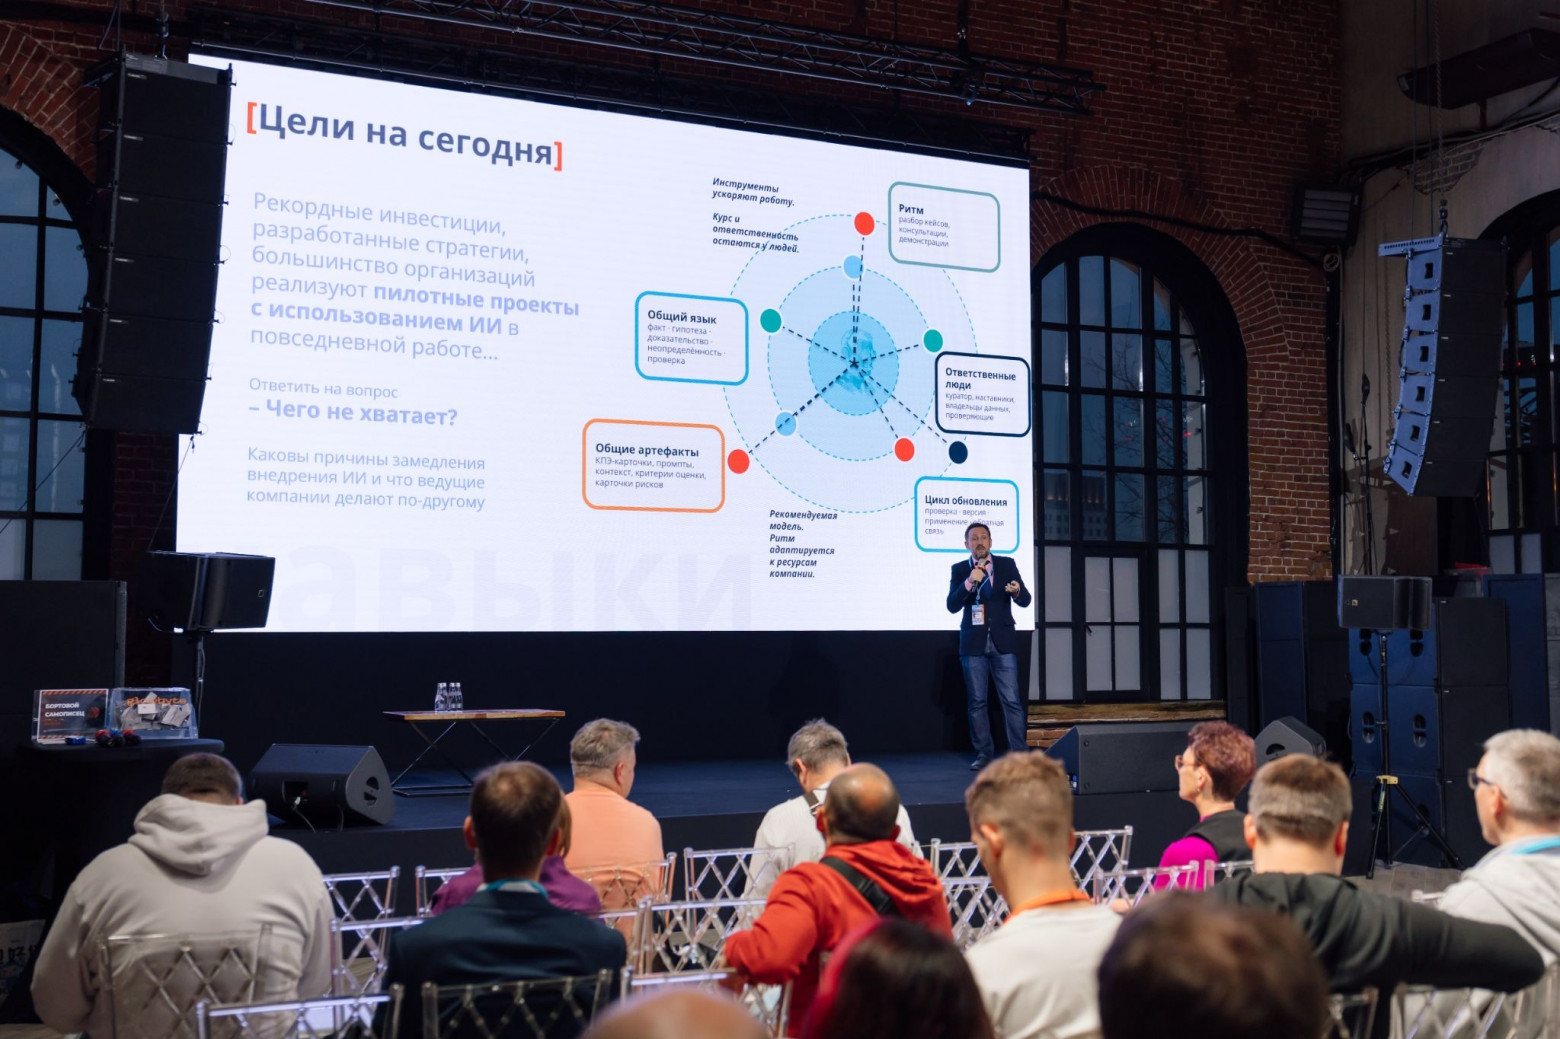
«ИИ ускоряет работу, но курс, проверка и ответственность должны оставаться у человека. Будущая грамотность аналитика — это способность поставить вопрос, подготовить контекст, направить ИИ, проверить ответ, объяснить неопределенность и принять ответственность за результат», — отметил Андрей Демидов, основатель проекта DataYoga.
Продолжить читать

