13 августа 2026, 09:20
Публичный инициатива Assembly Hall of Shame выявил самую медленную отдельную инструкцию x86

Исследователь аппаратного обеспечения под ником Кристофер Домас (aka xoreaxeaxeax) представил проект «деоптимизации ЦП». В рамках решения разработчик решил найти самую медленную отдельную инструкцию x86, а равным образом разработал «зал позора» (Assembly Hall of Shame) — худшая из инструкций (fxrstor64) выполняет 198 миллиардов циклов за 62 секунды.
Для оптимизации работы программного обеспечения на аппаратном обеспечении аналитика задержки инструкций рассматривает время, необходимое для выполнения низкоуровневых инструкций на процессоре, либо для оптимизации архитектуры, либо для оптимизации приложений для работы на конкретной архитектуре. Домас использует другой решение в своей таблице лидеров среди инструкций, которая направлена не на максимально быстрое выполнение инструкций ассемблера, а на максимально медленное, чтобы измерить эффективность единственной инструкции с наибольшей задержкой.
Победителем здесь стала инструкция fxrstor64, выполнение которой заняло 62 секунды, или более 198 миллиардов циклов. Эта инструкция восстанавливает состояние регистров, используемых для SIMD-вычислений, в 512-байтовую ячейку памяти. Чтобы достичь наивысшего (самого медленного) результата, Домас сначала использовал свой собственный средство mmiotic для поиска области с высокой задержкой во внутренней сети PCIe, а затем заставил чип скачать 512-байтовое состояние из MMIO (Memory-Mapped I/O), по существу, обрабатывая все эти 512 байт как можно медленнее. На это потребовалось 74 миллиарда циклов, или чуть более 23 секунд. Затем Домас пошёл дальше, используя серию 4-байтовых операций чтения из другого регистра MMIO с высокой задержкой, перегружая root complex PCIe процессора и заставляя восстановление состояния ставиться в очередь за ненужными операциями чтения. Второй шаг — использование инструкций AMX, доступных в Intel Sapphire Rapids для xrstore64. Область состояний увеличена с 512 байт до 8 КБ, что может привести к зависанию инструкции свыше на 1 триллион циклов.
Таблица лидеров для x86 уже доступна на GitHub, и, похоже, Домас планирует также создать таблицы лидеров для ARM и RISC-V. Для проведения тестов действуют некоторое количество правил. Домас сообщает, что подходит любая конфигурация, если оценивается только выполнение одной инструкции. Инструкции, прерываемые системой, не допускаются, как и эмулированные инструкции, выполняемые в обработчике. Все времена нормализованы по сравнению с базовой тактовой частоты процессора, и все платформы тестировались без аппаратных модификаций. Здесь мы имеем дело с ассемблерным кодом, следовательно рейтинг зависит не столько от конкретной инструкции, сколько от того, что с ней делается.
Для тестирования Домас использовал главным образом два процессора: Intel Core i7-8559U и AMD Ryzen 7 5800H (Trigkey S5). Тем не менее для инструкции rdmsr они использовали процессор VIA Eden, серию встраиваемых процессоров начала 2000-х годов. Команда rdmsr используется для чтения регистра, специфичного для модели, или MSR. По словам Домаса, VIA «использует недокументированный регистр по адресу 0x133, который обеспечивает невероятно высокое время отклика». Выполнение этой команды заняло 202 микросекунды или 161 602 цикла.
Это не первая попытка разработчика поэкспериментировать с низкоуровневыми инструкциями. Более ранний инициатива, называемый movfuscator, представляет собой компилятор C, который использует исключительно команду mov (перемещение).
Первые места рейтинга самых медленных инструкций x86 от Домаса с конца:
nop (ничего не делает) - 1 цикл 0 наносекунд.
nop16. Стратегия: обычная команда nop оказалась слишком короткой, но как сделать так, чтобы ничего не занимало больше времени? Попробуем longnnnnng nop. Процессор Intel(R) Core(TM) i7-8559U @ 2.70GHz, "data16 data16 data16 data16 data16 data16 data16 nopl 0x00000000(%%eax,%%eax,1)": 20 циклов, 7 наносекунд.
rdtsc (просто справочная инструкция для ориентира): 49 циклов, 18 наносекунд.
Читают сейчас
10 минут назад
NVIDIA выпустила открытую схема, которая определяет, кто и когда говорил
NVIDIA выпустила Nemotron 3 Diarization, компактную схема для определения того, кто и когда говорит в аудиозаписи. Она содержит приблизительно 100 млн параметров, работает с прямыми эфирами и готовыми
1 час назад
OpenAI может представить always-on агента на DevDay
В коде и интерфейсе ChatGPT начали всплывать следы нового агента под коротким названием «o». И да, судя по всему, OpenAI снова решила, что одной буквы для продукта вполне в достаточной степени. Упомин
1 час назад
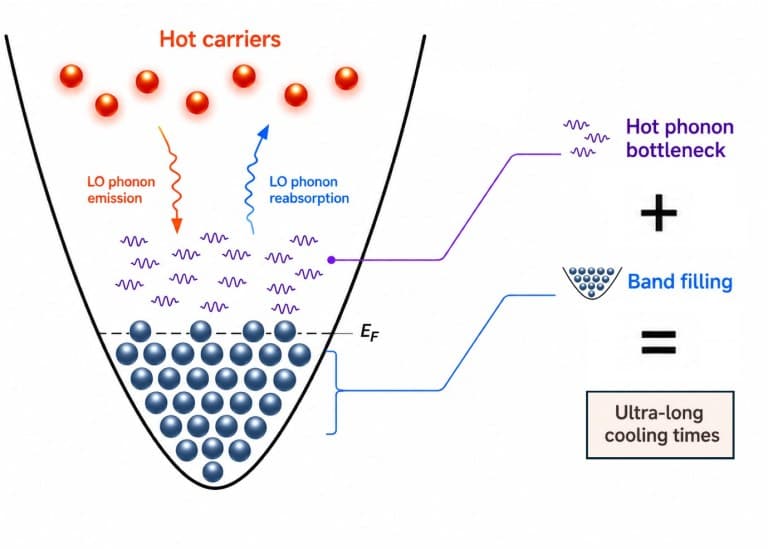
Новые солнечные панели на основе олова дольше удерживают тепло и могут показать рекордную производительность
Исследователи из Университета Гронингена в Нидерландах обнаружили, что перовскитные солнечные элементы на основе олова могут замедлять потерю тепла высокоэнергетическими «горячими электронами». Это мо
2 часа назад
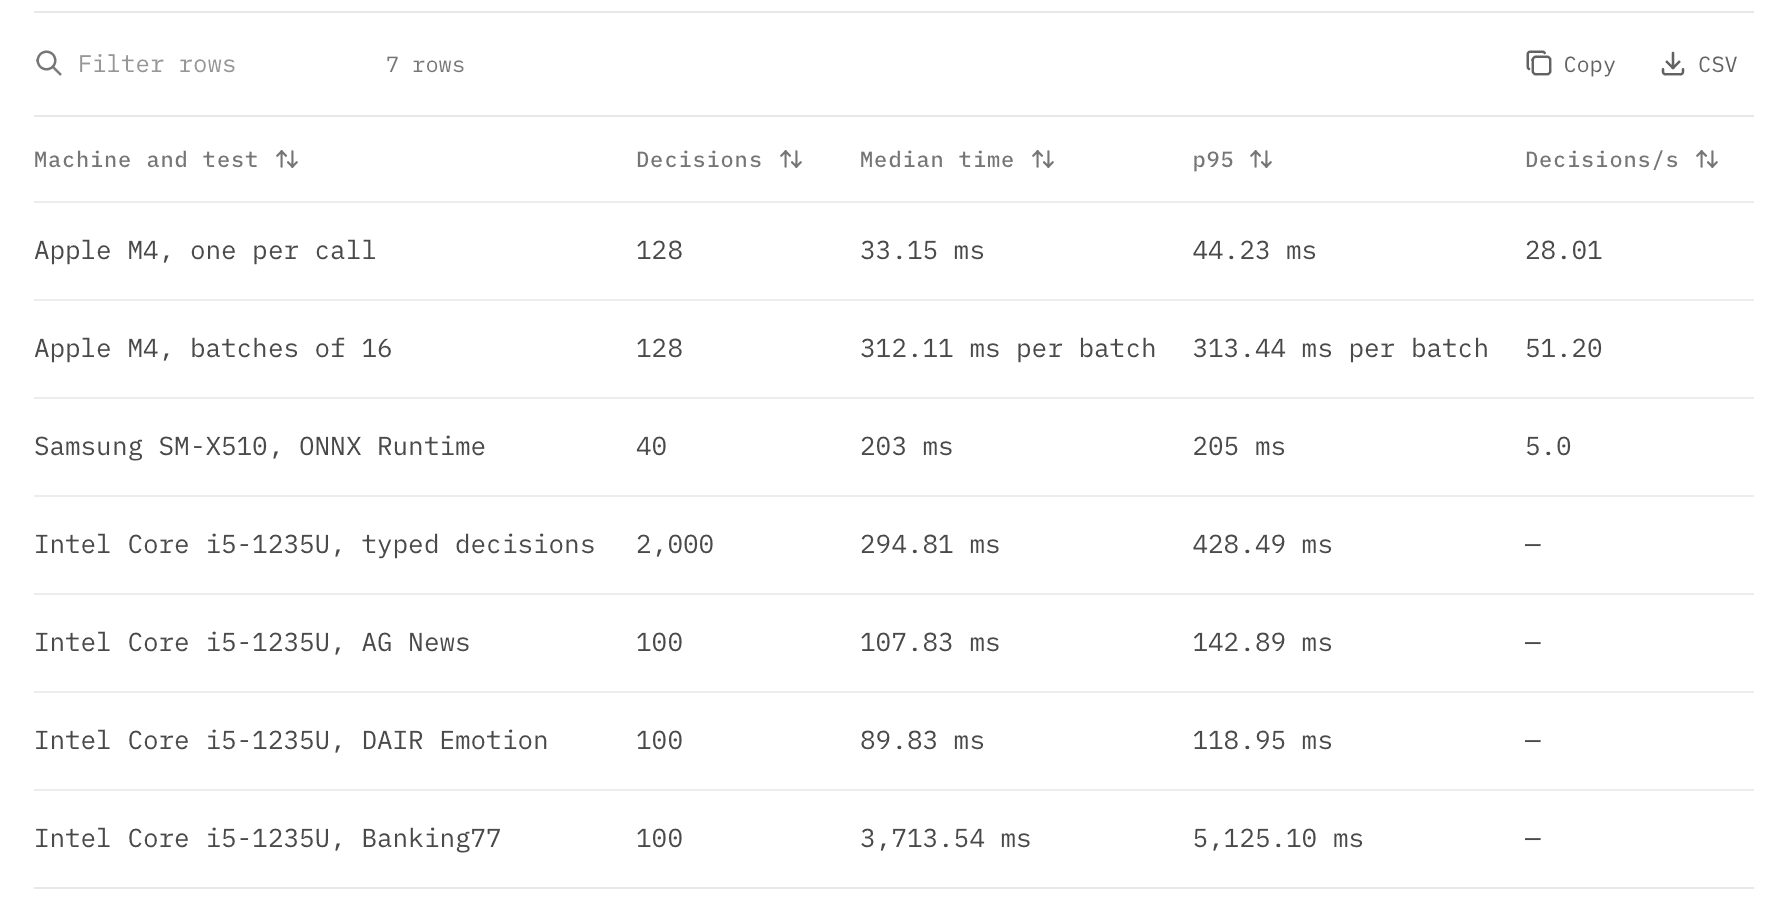
Julia 1: выпуск модели в духе Jev с открытыми весами и запуском на CPU
У Supersonic Labs вышла Julia 1 — небольшая схема для классификации текстов и выбора из заданных вариантов. В ней 144 млн параметров, веса занимают приблизительно 550 МБ, а для запуска достаточно CPU.
2 часа назад
В Outlook появится опция автоматической проверки орфографии перед отправкой писем
В Outlook появится функция автоматической проверки орфографии перед отправкой писем. Она заработает у части пользователей с октября 2026 года, а полноценный запускание ожидается в середине декабря. В