24 марта 2026, 14:15
v2a-модель PrismAudio учится озвучивать видео, разделяя смысл, время, эстетику и пространство

Авторы из команды FunAudioLLM (входящей в Alibaba Group) представили PrismAudio – свежий каркас для генерации звука по видео (video-to-audio, v2a), который кардинально меняет решение к этой задаче.
Вместо того чтобы пытаться оптимизировать всё и сразу с помощью единой функции потерь, как это делалось раньше, PrismAudio разбивает процесс на четыре специализированных потока рассуждений – семантический, темпоральный, эстетический и пространственный. Каждый из них обучается с помощью собственной функции награды в контексте многомерного обучения с подкреплением (multi-dimensional RL).
Результаты уже доступны для тестирования на платформах Hugging Face и ModelScope.
Задача существующих v2a-моделей, как объясняют разработчики в опубликованной статье, заключается в “запутывании целей”. Когда одна опция потерь пытается одновременно отвечать за соответствие звука содержимому кадра (семантика), его синхронность с движениями (темпоральность), высокое качество (эстетика) и правильное позиционирование в пространстве, модель неизбежно идёт на компромиссы.
PrismAudio обходит это ограничение, предлагая decomposed multi-CoT. Вместо монолитного пути генерации используются четыре независимых потока:
Semantic CoT (определяет, что должно звучать),
Temporal CoT (вычисляет, когда должен раздаться звук),
Aesthetic CoT (отвечает за качество звучания)
и Spatial CoT (определяет откуда идёт звук).
Такая декомпозиция делает процесс не только более точным, но и объяснимым.
Ключевое новшество фреймворка – многомерное обучение с подкреплением. Каждый из четырёх CoT-потоков получил свою собственную функцию награды: MS-CLAP для семантики, Synchformer для синхронизации, StereoCRW для пространственной точности и ряд других для эстетического качества. Это даёт возможность оптимизировать каждое измерение независимо, без ущерба для остальных.
Чтобы сделать такое комплексное обучение вычислительно возможным, исследователи разработали метод Fast-GRPO. Он ограничивает случайность узким временны́м окном и позволяет добиться более высокой производительности всего за 200 шагов обучения, в то время как предыдущие методы требовали 600.
Для объективной оценки возможностей новой модели разработчики создали собственный бенчмарк AudioCanvas. В отличие от существующих датасетов, он сбалансирован по распределению и включает в себя сложные сценарии, в том числе 300 классов одиночных событий и 500 примеров с несколькими одновременными звуками. Именно на таких внедоменных сложных сценах, где другие модели дают ошибка, PrismAudio демонстрирует наибольшую устойчивость.
Сравнение с конкурентами – HunyuanVideo-Foley, MMAudio, ThinkSound – проведённое на тестовом наборе VGGSound и новом бенчмарке AudioCanvas, показывает, что PrismAudio (с 518 млн параметров) превосходит соперников по всем четырём ключевым метрикам: семантике (CLAP), темпоральной синхронности (DeSync), эстетике (PQ, CE, CU) и пространственной точности (GCC, CRW). Особенно впечатляет разрыв в субъективных оценках (MOS) – пользователи ставят звуку от PrismAudio 4,21 балла против 4,05 у ближайшего преследователя (ThinkSound) при оценке качества и 4,22 против 4,18 при оценке соответствия видео. Одновременно схема работает быстрее всех – 0,63 секунды на генерацию, что сопоставимо с MMAudio и быстрее, чем ThinkSound (1,07 секунды) и HunyuanVideo-Foley (10,63 секунды).
Технические детали, демо, текст исследования: официальной странице проекта.
Проверка генерации: демо на Hugging Face Spaces или ModelScope Studio.
Читают сейчас
24 минуты назад
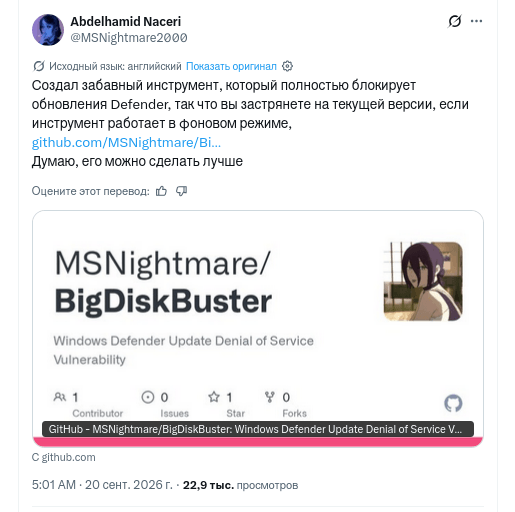
Nightmare Eclipse опубликовал новую уязвимость нулевого дня в Microsoft Defender
Инженер‑исследователь по ИБ и бывший сотрудник подразделения Microsoft V&M (Microsoft Security Response Center: Vulnerabilities & Mitigation) по имени Абдельхамид Насери (aka Nightmare Eclipse или MSN
28 минут назад
Tesla возобновила приём предзаказов на Roadster с депозитом в $50 тысяч
Tesla возобновила приём предзаказов на электрический спорткар Roadster, требуя внести депозит в размере $50 тыс.: $5 тыс. с кредитной карты и $45 тыс. банковским переводом на протяжении 10 дней с моме
1 час назад
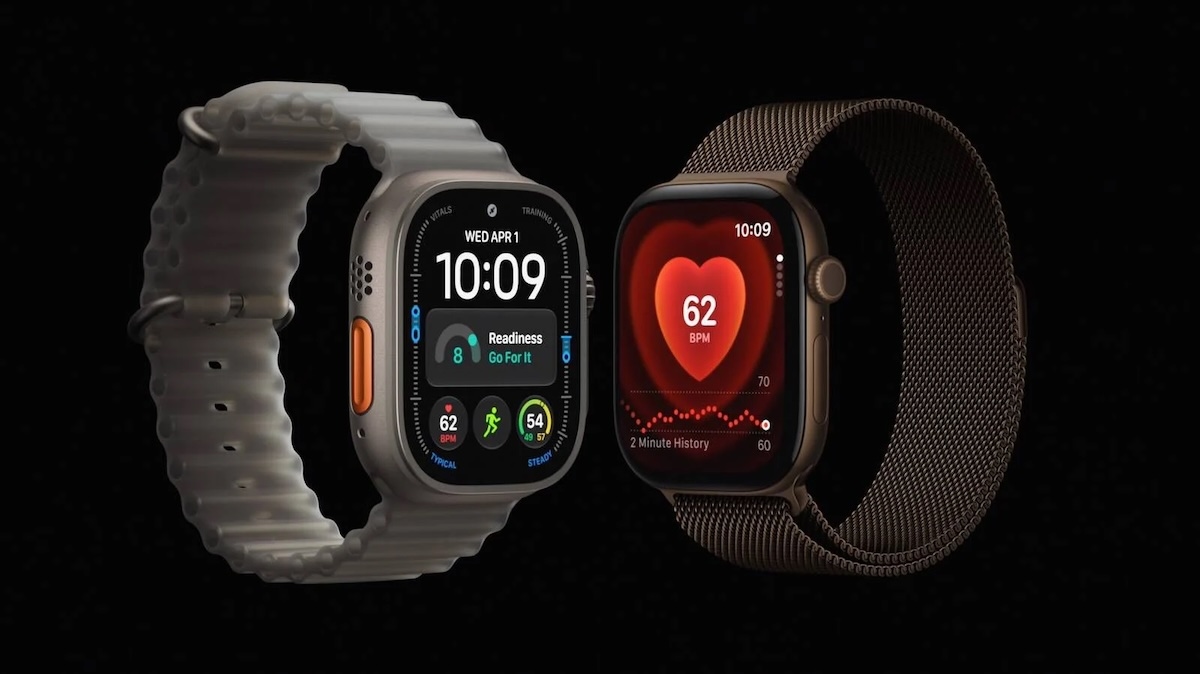
Владельцы Apple Watch Ultra 4 и Series 12 столкнулись с проблемой перезагрузок устройств из‑за Apple Neural Engine
Первые владельцы новых смарт‑часов Apple Watch Ultra 4 и Apple Watch Series 12 сообщают о неожиданных перезагрузках своих устройств. Диагностические журналы указывают на связь подобных сбоев с сопроце
1 час назад
Власти Испании распорядились заблокировать Archive.today и его зеркала
Комиссия по интеллектуальной собственности Министерства культуры Испании распорядилась заблокировать несколько доменов бесплатного сервиса по архивированию веб‑страниц Archive.today. При попытке получ
1 час назад
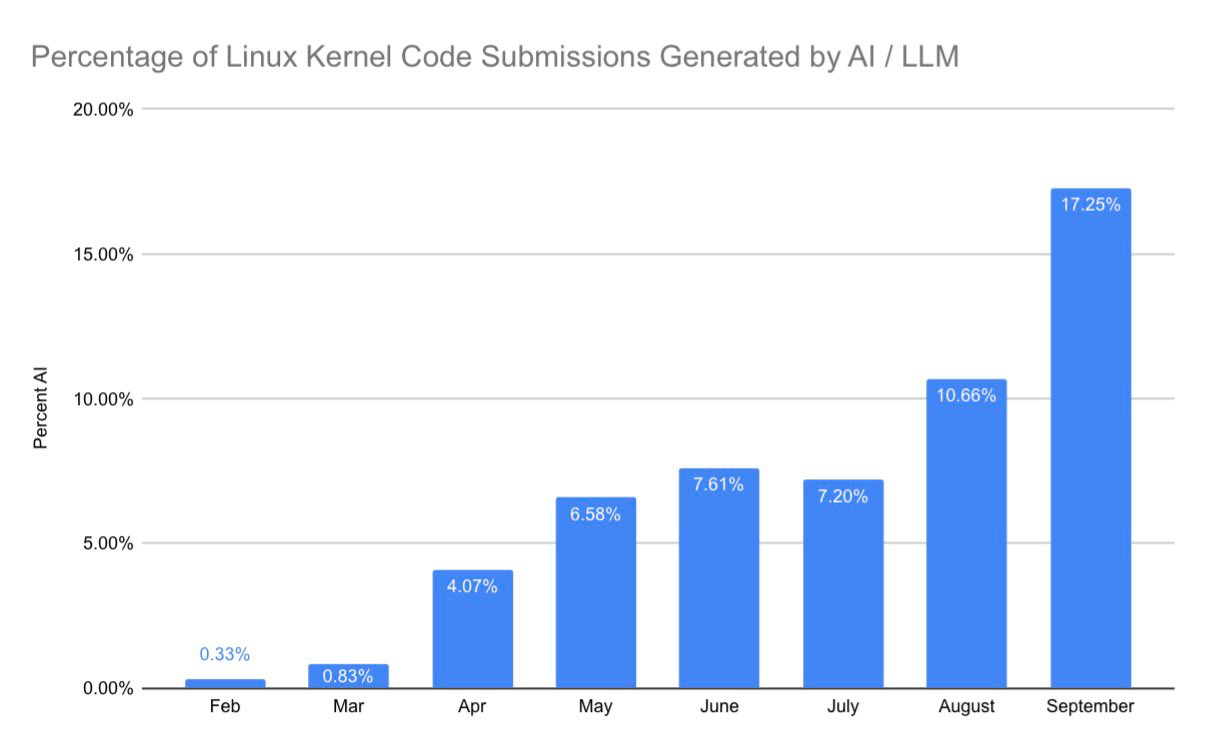
Доля AI-патчей в движок Linux выросла с 0,33% до 17,25%
Каждый шестой патч для Linux Kernel в сентябре был написан с помощью AI. За прошлую неделю разработчики отправили 1634 патча, созданных с участием AI. Это новый рекорд. Доля растёт почти каждый месяц: