9 июня 2026, 23:49
Выпущен тест производительности FrontierCode для оценки ИИ-моделей по «качеству пулл-реквестов»


Организация Cognition выпустила новый бенчмарк FrontierCode для измерения «способности ИИ-моделей выдерживать стандарты качества реальных кодовых баз». Согласно заявлению его создателей, обычно кодинговые бенчмарки для LLM оценивают лишь формальное выполнение задач, а теперь пора задаваться более сложным вопросом: «могут ли модели писать качественный исходник?»
Чтобы оценить это, они оттолкнулись от другого вопроса: «Если бы действия модели были реальным пулл-реквестом, то смерджил бы мейнтейнер его или нет?»
Как признают создатели, здесь существуют как объективные критерии (возможно выделить «блокеры», с которыми точно не будет смерджен), так и более сложная субъективная составляющая. Для создания тестовых заданий и критериев оценки они обратились к мейнтейнерам ряда реальных репозиториев.
Получившаяся система оценки результатов учитывает ряд критериев:
Behavioural correctness: решает ли код от машины поставленную задачу?
Regression safety: не ломает ли он при этом что-то другое в кодовой базе?
Mechanical cleanliness: проходит ли он проверки проекта вроде lint check?
Test correctness: будут ли тесты, созданные LLM для проверки своего решения, падать без него?
Scope: затрагивает ли решение «лишние» места в коде, не требующиеся для этой задачи?
Code quality: соответствует ли решение конвенциям кодовой базы, следует ли паттернам проектирования, остаётся ли читабельным?
Там, где для оценки этого возможно использовать стандартные бинарные средства вроде юнит-тестов, бенчмарк обращается к ним. Но в более сложных вопросах (вроде идиоматичности и читаемости кода) для оценки прибегают к LLM.
Всего в бенчмарке 150 задач, и 50 наиболее сложных из них выделены в отдельную подгруппу «Diamond». При выходе бенчмарка даже лидирующая в нём модель Opus 4.8 набирала лишь 13.8%, что куда ниже, чем у известных бенчмарков вроде SWE-bench. Но почти сразу за ним последовал выпуск модели Fable 5 (вероятно, события были заранее согласованы), и в его анонсе приводится новый рекордный результат в 29.3%.
Точные задачи публично не раскрываются, чтобы избежать проблемы contamination, когда модели уже знают из обучающего датасета, как проходить проверка. Среди доступной информации сообщается, что разделение задач между языками программирования разнообразнее, чем у бенчмарков SWE-bench Pro и DeepSWE:

В IT-сообществе многие поддержали основную идею «оценивать качество кода от LLM», соглашаясь, что в 2026 году это насущный вопрос. Тем не менее к конкретной реализации возникают и уточнения: например, «Насколько вопроизводимы результаты, не получаются ли при перезапуске бенчмарка значимо отличающиеся числа?»
Читают сейчас
1 час назад
OpenAI привлекла сотни сторонних подрядчиков, которые читают и оценивают реальные переписки пользователей с ChatGPT
OpenAI привлекла сотни сторонних подрядчиков, которые читают и оценивают реальные переписки пользователей с ChatGPT для улучшения моделей искусственного интеллекта компании. Об инициативе под кодовым
2 часа назад
Карманный LoRa-коммуникатор ThinkNode M9 с QWERTY-клавиатурой
Компания Elecrow выпустила ThinkNode M9 — компактный коммуникатор для обмена сообщениями без сотовой связи и доступа к интернету. Внешне устройство напоминает старые смартфоны BlackBerry: почти полови
2 часа назад
Gartner: ИИ-компаниям пока нельзя доверять серьёзные задачи бизнеса
За ошибку искусственного интеллекта отвечать будет не тот, кто его разработал, а тот, кто им пользовался. И это уже не догадка, а прямое предупреждение крупнейшей аналитической фирмы, как сообщает The
2 часа назад
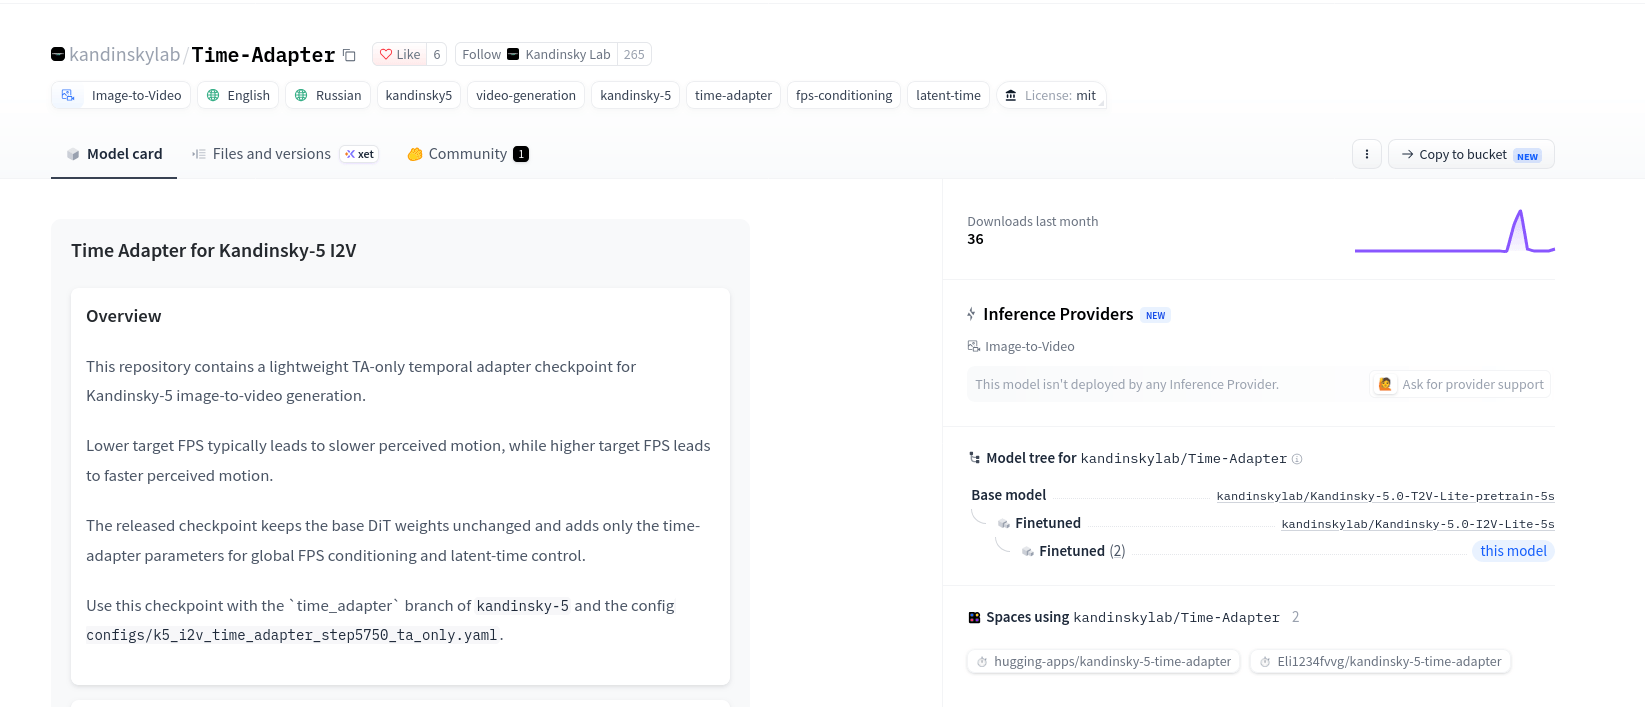
«Сбер» показал Time Adapter — надстройку к генеративным моделям для управления динамикой событий и частотой кадров
Команда ИИ-проекта Kandinsky «Сбера» разработала подход под названием Time Adapter. Инициатива предоставляет собой надстройку к генеративным моделям, которая управляет динамикой событий и частотой кад
2 часа назад
В Wizards of the Coast подтвердили: сюжет Warlock будет строго линейным
После триумфа Baldur’s Gate 3 кажется, что абсолютная свобода выбора стала обязательным атрибутом любой фэнтезийной RPG. Larian Studios задала свежий «золотой стандарт», к которому сегодня пытаются пр