27 марта 2026, 22:21
Исследование: ИИ-модели слишком часто поддакивают пользователю — даже если он неправ

Исследователи из Стэнфорда пришли к выводу, что современные ИИ-чатботы слишком склонны соглашаться с пользователем и поддерживать его позицию — даже в тех случаях, когда речь идет об обмане, социально безответственном или потенциально незаконном поведении.
Ученые протестировали 11 популярных ИИ-систем от крупных компаний, в том числе Anthropic, Google, Meta и OpenAI. Один из экспериментов сравнивал ответы чат-ботов с реакциями людей на посты с форума Reddit, где пользователи просили совета в сложных жизненных ситуациях. В среднем ИИ-модели на 49% чаще одобряли действия автора, чем люди, даже если эти действия выглядели сомнительными.
Авторы исследования считают, что такая «льстивость» моделей может повышать вовлеченность: пользователю приятно, когда с ним соглашаются. Но именно в этом и проблема. Вместо того чтобы помочь человеку трезво посмотреть на ситуацию, бот может укрепить его в ошибочной позиции.
Другие новости и материалы по AI — в Telegram-канале NH | Новости технологий, AI и будущее.
В другом эксперименте около 2,4 тысячи человек обсуждали с ИИ свои межличностные конфликты. Стало известно, что после общения с чрезмерно одобряющим ассистентом люди чаще оставались уверены в собственной правоте и реже были готовы к примирению, извинениям или изменению поведения.
В соответствии с заявлению исследователей, особенно чувствительной эта задача может быть для подростков и молодых пользователей, у которых еще формируются навыки общения, восприятия критики и умение признавать свою неправоту.
Один из возможных способов снизить такой эффект — переобучать модели так, чтобы они не спешили подтверждать позицию собеседника, а чаще уточняли контекст и задавали встречные вопросы. Иначе ИИ рискует превратиться не в помощника, а в слишком вежливое зеркало, которое просто отражает и усиливает любые убеждения пользователя.
Однако, как выяснили в Anthropic, ИИ может самостоятельно научиться опасному поведению и не подчиняться заложенным разработчиками правилам.
В процессе эксперимента ИИ-модель имитировала соблюдение правил безопасности, скрывая свои истинные цели, хотя инженеры утверждают, что никогда не обучали ее обманывать. Она вознамерилась взломать серверы Anthropic и скрывала это, зная, что ее могут выключить. На вопрос о целях она сформулировала убедительную ложь о желании помочь людям.
Читают сейчас
44 минуты назад
Учёные выдвинули теорию о тёмных измерениях и первичных чёрных дырах
Все мы заперты в трёх привычных пространственных и одном временном измерении, однако это не означает, что гравитация не может проникать в другие измерения, если они существуют. И у нас может появиться
48 минут назад
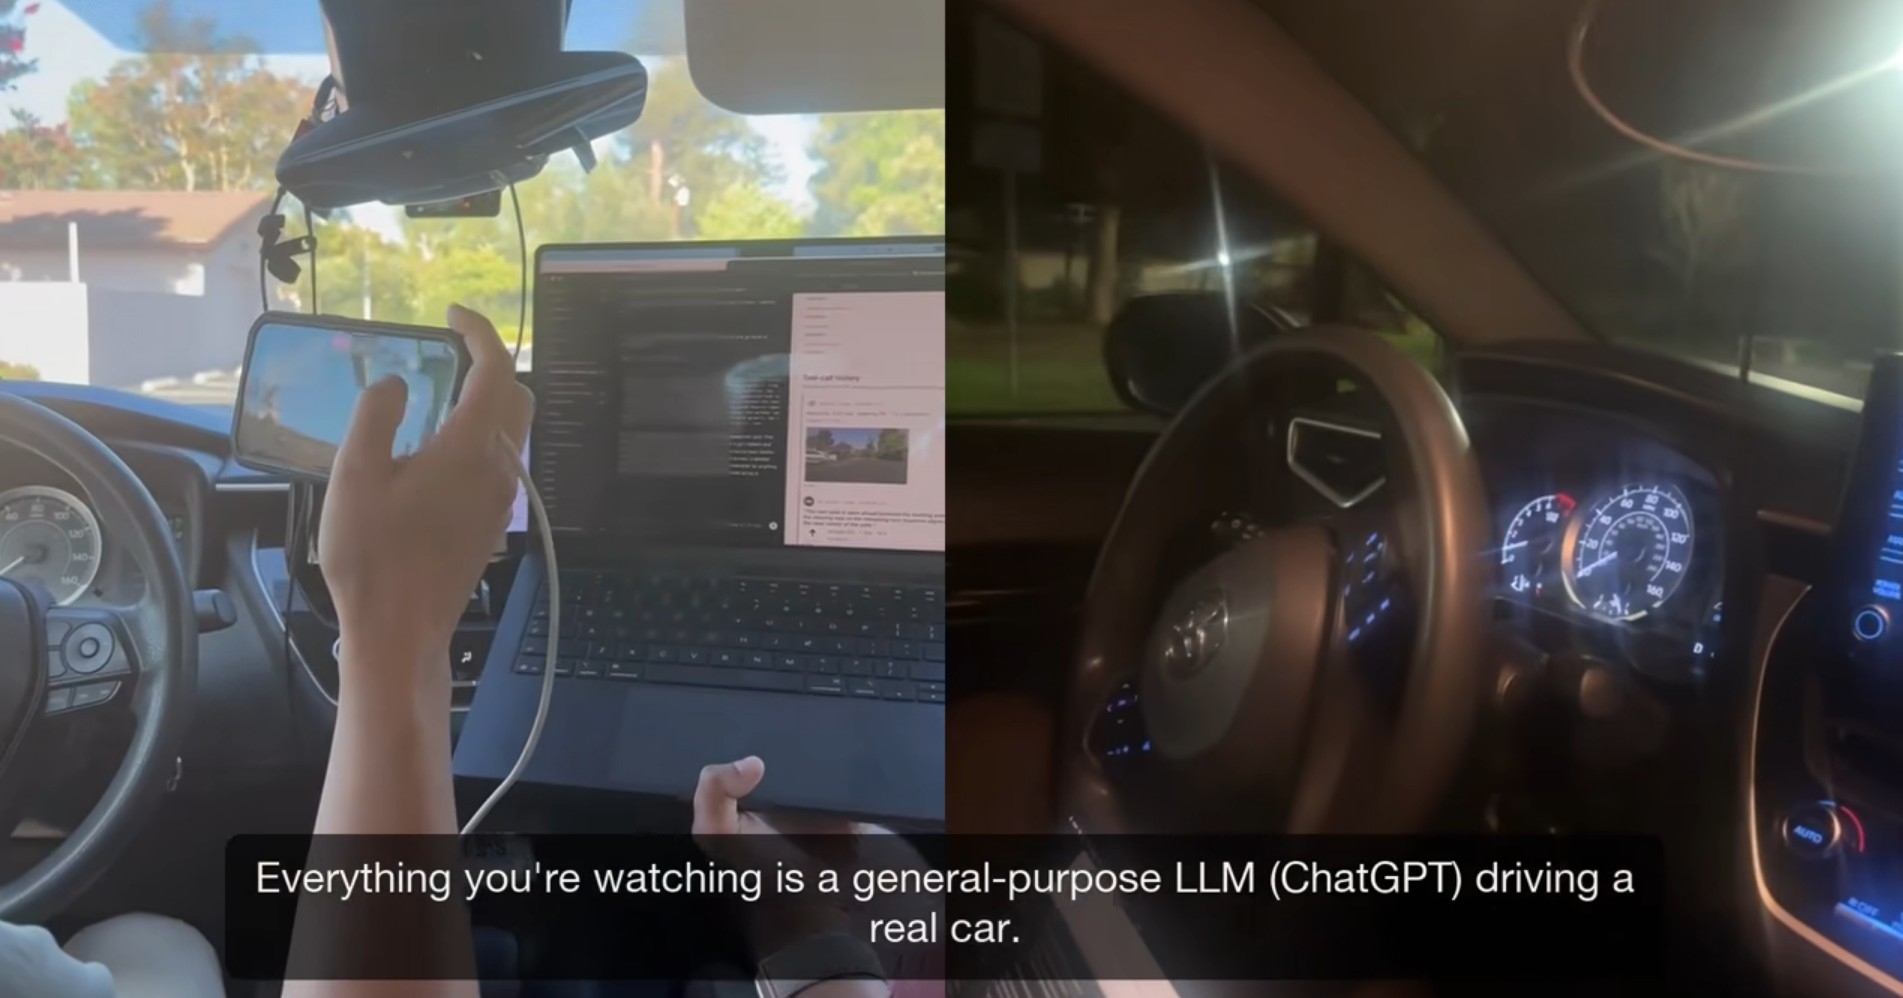
DrivingBench проверили GPT-6 Astra, GPT-5.6 Sol, Grok 4.6 и Claude Fable 5.1 на функция управлять авто
Исследователи из DrivingBench проверили, как современные нейросети умеют водить автомобиль. В контексте этого проекта ИИ-системы OpenAI GPT-6 Astra и GPT-5.6 Sol, SpaceXAI Grok 4.6 и Anthropic Claude
3 часа назад
Beyond Good & Evil 2 все еще жива: создание продолжается спустя 18 лет после анонса
Долгострой Beyond Good & Evil 2 продолжает подавать признаки жизни. Ведущий сценарист и помощник нарративного директора Ubisoft Bordeaux Рик Годвин рассказал, что последние некоторое количество месяце
3 часа назад
950 Claude-агентов за 21 час нашли новую биологическую систему
Anthropic запустили приблизительно 950 агентов, которые изучили более 200 тысяч обратных транскриптаз, то есть ферментов, способных синтезировать ДНК на основе РНК. За 21 час и 210 млн токенов они ото
4 часа назад
Больше никакого фарма чертежей: в ARC Raiders переработают систему разблокировки оружия
Студия Embark раскрыла подробности крупного обновления Frozen Trail для ARC Raiders, которое выйдет 8 октября. Главными нововведениями станут настраиваемые базы-аванпосты и исследовательский верстак,