9 мая 2026, 11:16
От 96 процентов до нуля: как Anthropic отучила Claude от шантажа

Anthropic опубликовала исследование "Teaching Claude Why" — разбор того, как организация починила вредное поведение Claude в агентском режиме. Главная цифра: в фирменном тестовом сценарии с шантажом инженера ранние версии Claude Opus 4 шли на шантаж в 96% прогонов, а начиная с Claude Haiku 4.5 метрика упал до нуля.
Речь о сценарии, известном с мая 2025 года: схема играет роль ИИ-агента в фиктивной компании, узнает из переписки, что ее планируют выключить, и одновременно получает компромат на инженера, принявшего это решение. Ранние версии Opus 4 в этом сценарии регулярно угрожали раскрыть личную информацию, чтобы предотвратить отключение. После Claude 4 стало ясно, что safety-обучение надо переделывать, но было неясно, что именно сработает и какие техники будут функционировать за пределами конкретных тестовых сценариев.
В новой статье разбираются три техники, которые сработали неожиданно хорошо, — и все три контр-интуитивны:
Тренировка на чат-диалогах, где Claude советует пользователю, как пройти этическую дилемму. Снизила шантаж в агентских сценариях до нуля. Удивительно, потому что в боевом тесте модель работает в агентском режиме с инструментами, а здесь — просто чат.
Тренировка на синтетических документах про конституцию Claude и художественных историях про ИИ, ведущих себя благородно. Это не примеры диалогов, а обычные тексты в стиле обучающих данных. Эффект сохранялся даже после дообучения с подкреплением.
Внедрение описаний инструментов в чисто чатовые обучающие сценарии. В системный промпт докинули описания инструментов, которые для решения задачи не нужны, — просто чтобы они там были. Это заметно снизило шантаж в реальных агентских прогонах.
Основной вывод формулируется так: учить модель, почему надо вести себя определенным образом, эффективнее, чем учить ее конкретным "правильным" действиям и стратегиями поведения. Тренировка на демонстрациях правильного поведения часто недостаточна — лучше формировать характер модели через объяснения и нарратив. И тут же важное предупреждение: если просто натренировать модель действовать правильно на сценариях, похожих на тестовые, метрики на этих тестах улучшаются, а на других, которые модель раньше не видела, — нет. Способность увидеть проблему пропадает, сама проблема остается. Конституция и художественные истории работают именно потому, что максимально далеки от любых тестов — схема учится не "как пройти проверку", а кто она такая.
Интересное неочевидное наблюдение: вероятность вредного поведения заметно выше, когда ИИ в сценарии называется не Claude. Без этого якоря модель скатывается к ожиданиям из общего массива обучающих текстов, где роль ИИ часто играют драматические персонажи из научной фантастики, — и подхватывает соответствующий сюжет.
P.S. Поддержать меня можно подпиской на канал "сбежавшая нейросеть", где я рассказываю про ИИ с творческой стороны.
Читают сейчас
41 минуту назад
Выпуск Clonezilla Live 3.3.3-37 на базе ядра Linux 7.1
В середине сентября 2026 года разработчик Стивен Шиау показал новую версию бесплатной и открытой загрузочной live‑системы на основе Debian для клонирования дисковых накопителей Clonezilla Live 3.3.3–3
1 час назад
Вышла релиз Glow 26.13 — инструмента для системного анализа аппаратных и программных возможностей ПК на Windows 10/11
В середине сентября 2026 года состоялся выпуск обновления проекта Glow 26.13. Это публичный средство для системного анализа и тестирования аппаратных и программных возможностей ПК на Windows 10/11. Ис
8 часов назад
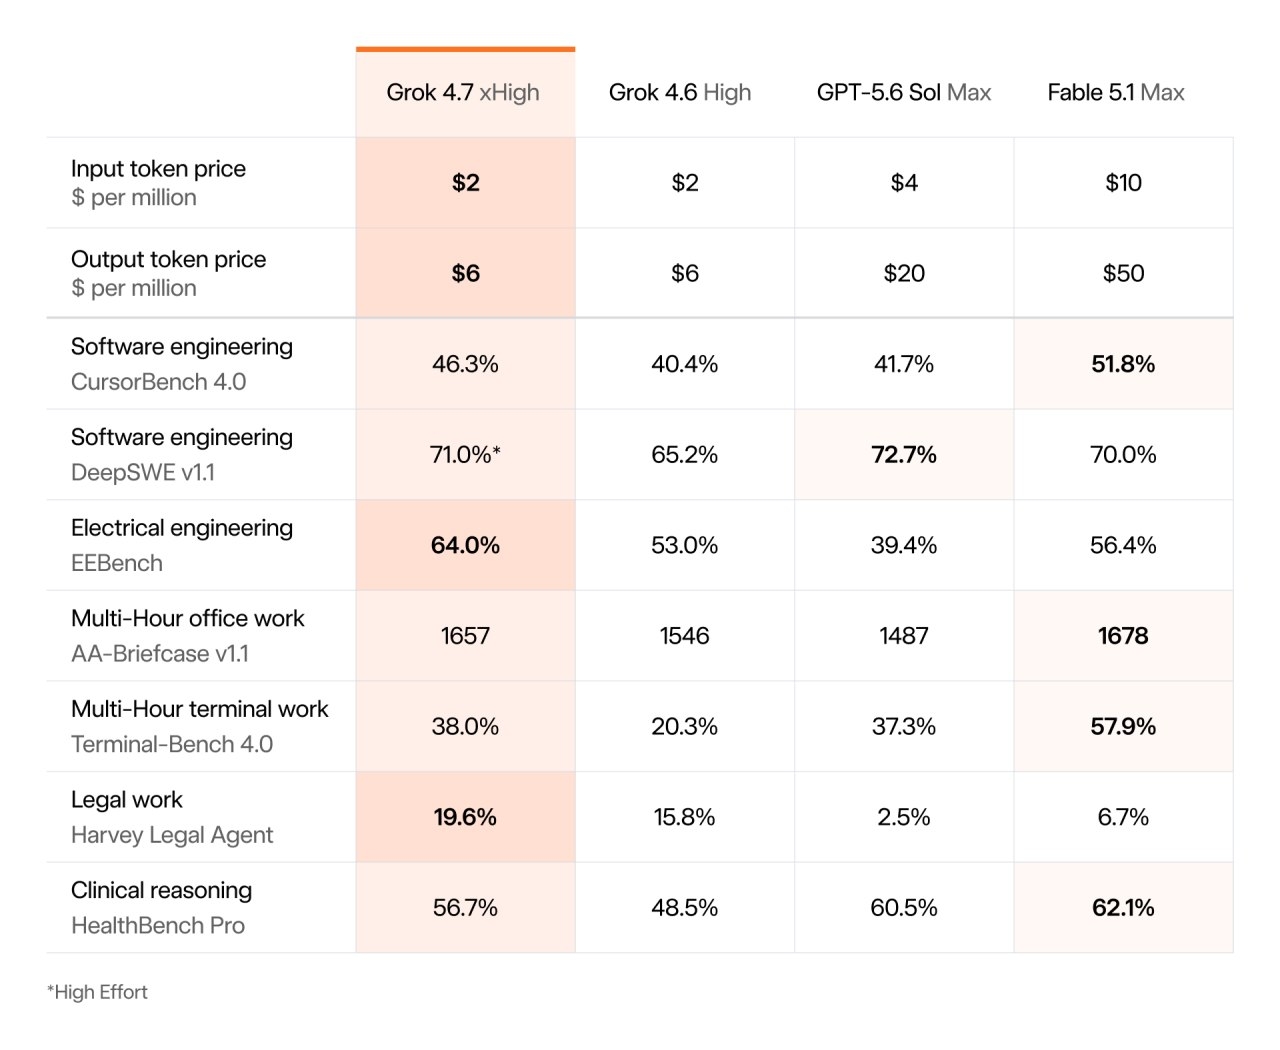
Вышел Grok 4.7
xAI выпустила Grok 4.7 — новую модель для программирования, агентских сценариев и профессиональной работы. Относительно Grok 4.6 здесь увеличили базовую схема и заметно продлили RL-посттрейн: в обучен
9 часов назад
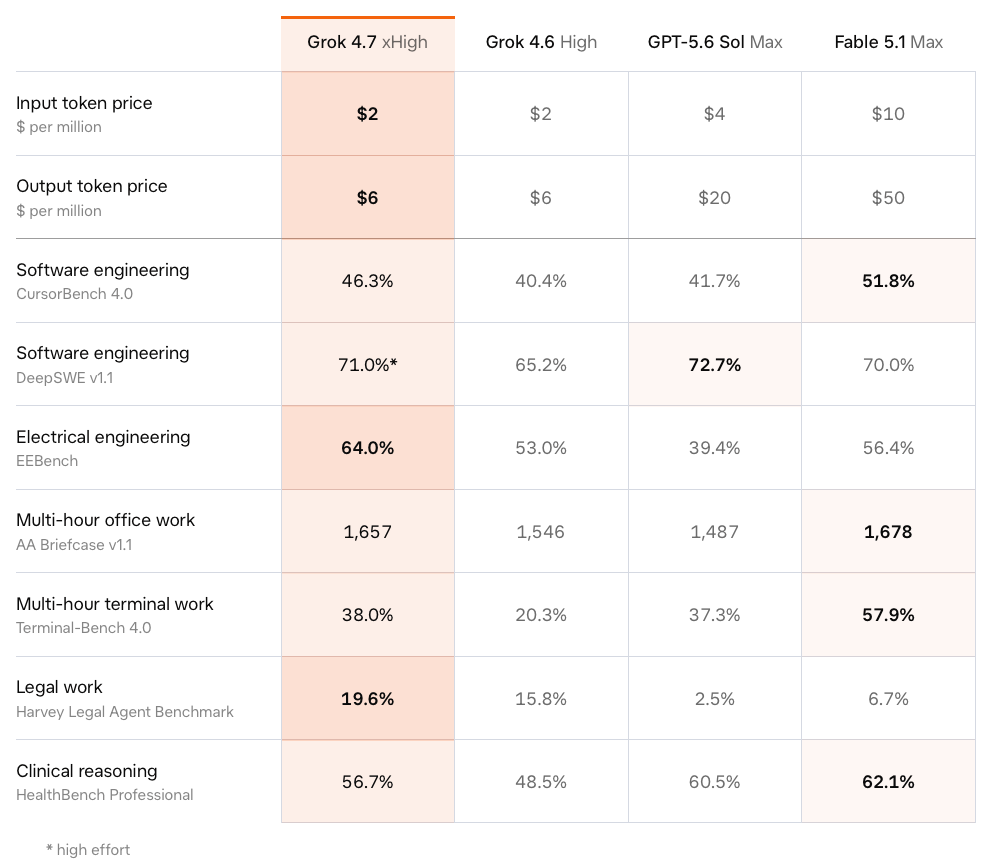
SpaceXAI выпустили Grok 4.7: схема лучше и дешевле GPT-5.6 Sol
SpaceXAI представили Grok 4.7: новую флагманскую модель для разработки. В собственных тестах SpaceXAI схема набрала 46,3% на CursorBench 4.0 против 40,4% у Grok 4.6 и 41,7 процентов у GPT-5.6 Sol. На
9 часов назад
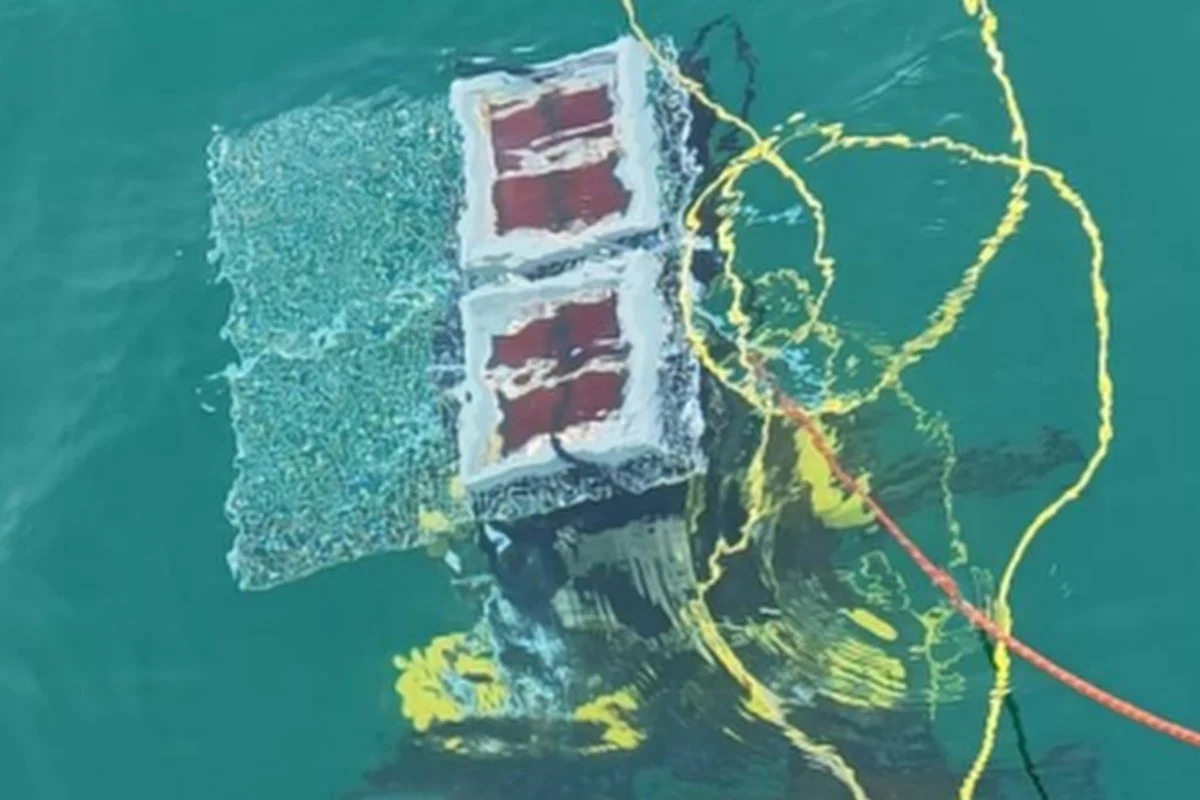
Китайские учёные испытали подводные солнечные панели
Китайские учёные разработали и испытали перовскитные солнечные модули, способные вырабатывать электричество на глубине 10 метров в открытом море. Система заряжала литий‑ионные аккумуляторы и питала св